
7. 학습 지켜보기와 결과 읽기
📍 지금 어디: Task Owner 7/7 — ① 설계 → ② Task 만들기 → ③ Workspace → ④ 학습·게시 → ⑤ 승인 → ⑥ 캠페인 → ⑦ 결과
화면: FedOps Console · 상대편: Client 가 라운드에 참여하고 있다 · 다음: (선택) 모델 활용 트랙
🎯 이 단계에서 하는 일: 라운드가 진행되는 것을 지켜보고, 끝나면 새로 생긴 Global Model 과 지표를 읽습니다. 그리고 “연합학습이 돌았고, 두 병원의 학습이 합쳐졌다”는 것을 화면에서 확인합니다. Owner 는 모든 참여자의 상태를 보고, 각 Client 는 자기 상태만 봅니다.
1) 진행 지켜보기
Client 가 Clients per round 만큼 붙으면 라운드가 시작됩니다. 6장에서 열어 둔 live log 에 라운드가 넘어가는 것이 보입니다. 먼저 붙은 쪽은 Studio 에서 waiting_round 로 기다리다가, 두 번째 참여자가 붙으면 라운드가 진행됩니다. 2026-10-20 실측에서는 두 병원이 모두 붙은 뒤 2라운드가 3초 만에 끝났습니다(live log: Run finished 2 round(s)). 시간의 대부분은 두 참여자가 모두 준비(점검·접속)되기를 기다리는 시간입니다.
학습이 끝나면 서버는 스스로 내려가 Server Offline 이 됩니다.
끝나면 Console 에서 결과를 봅니다.
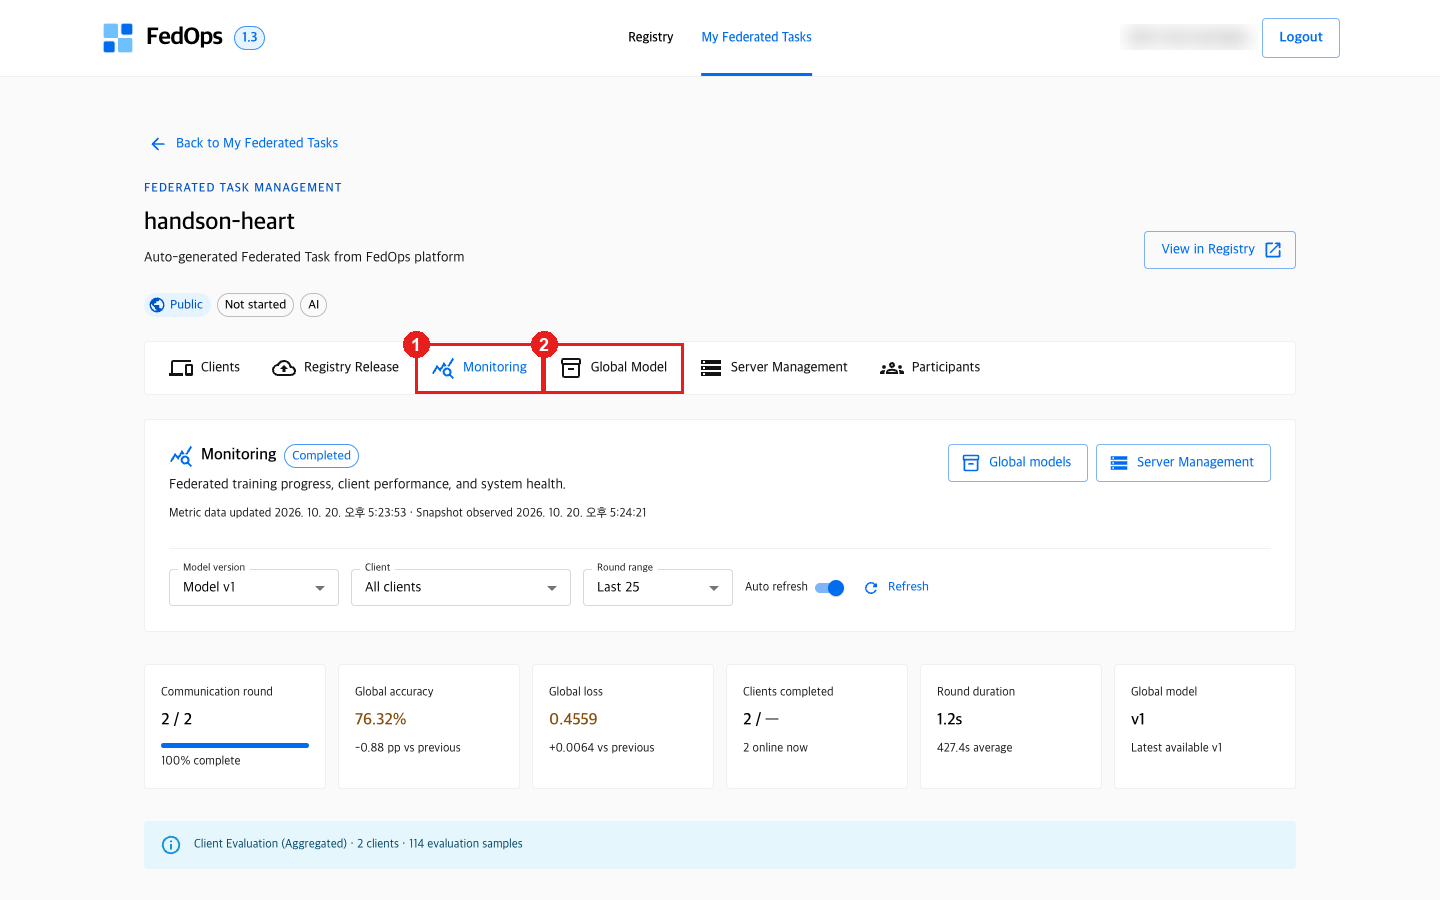
- Console 의
handson-heart에서 Monitoring 탭을 누른다. - 다 봤으면 Global Model 탭을 누른다.
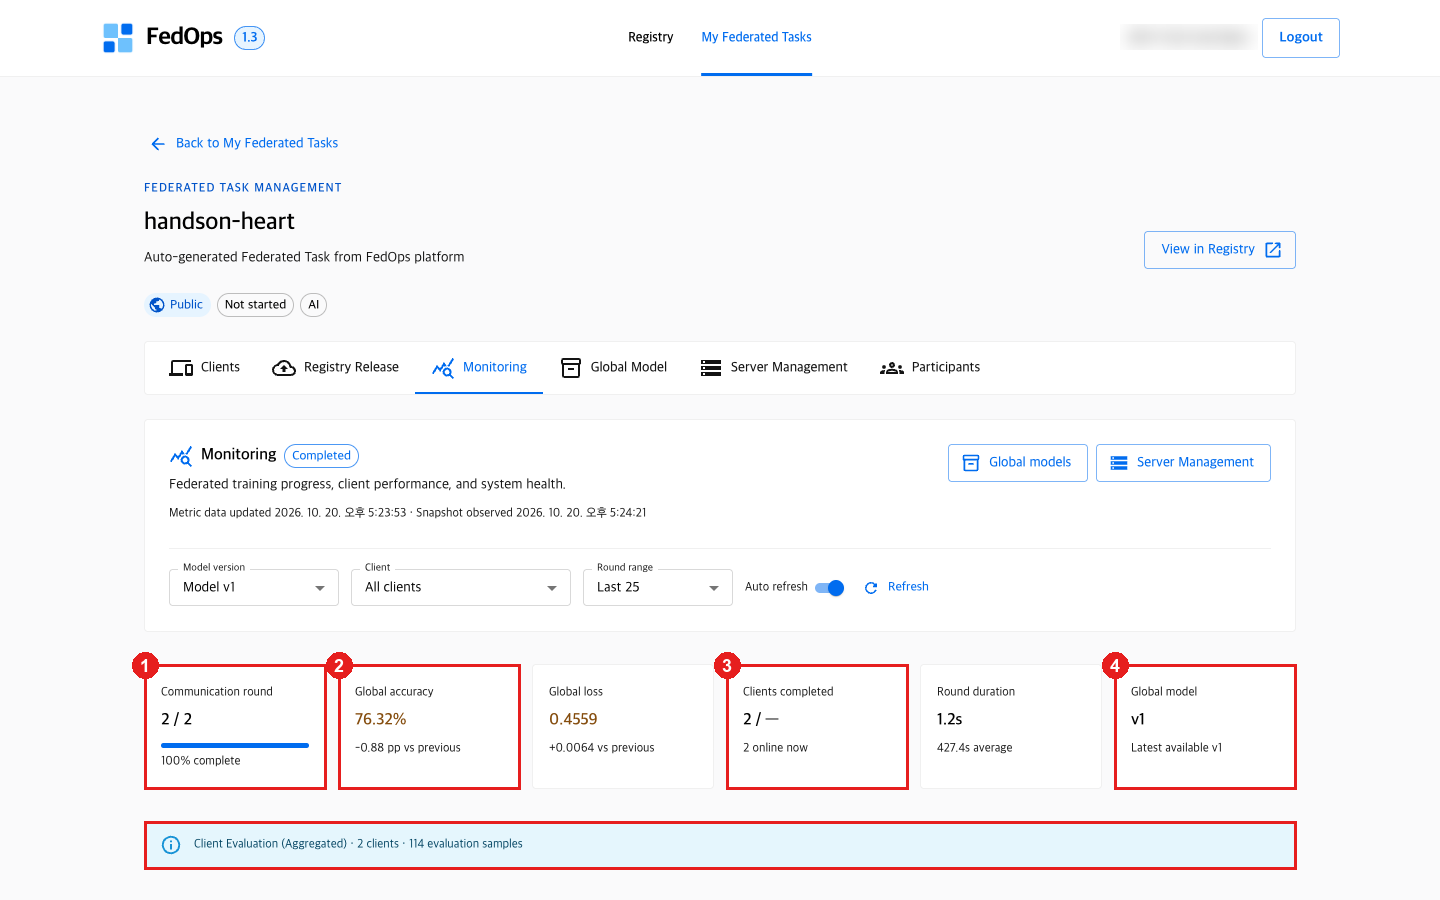
Monitoring 에 Communication round 2 / 2 · 100% complete 와 Global accuracy · Global loss, 학습을 마친 Client 수가 나옵니다. ① 라운드, ② Global accuracy, ③ 학습을 마친 Client 수, ④ 새 Global Model 버전입니다. 아래 파란 줄의 2 clients · 114 evaluation samples 는 두 병원의 test 행을 합친 수입니다(헝가리 53 + 클리블랜드 61).
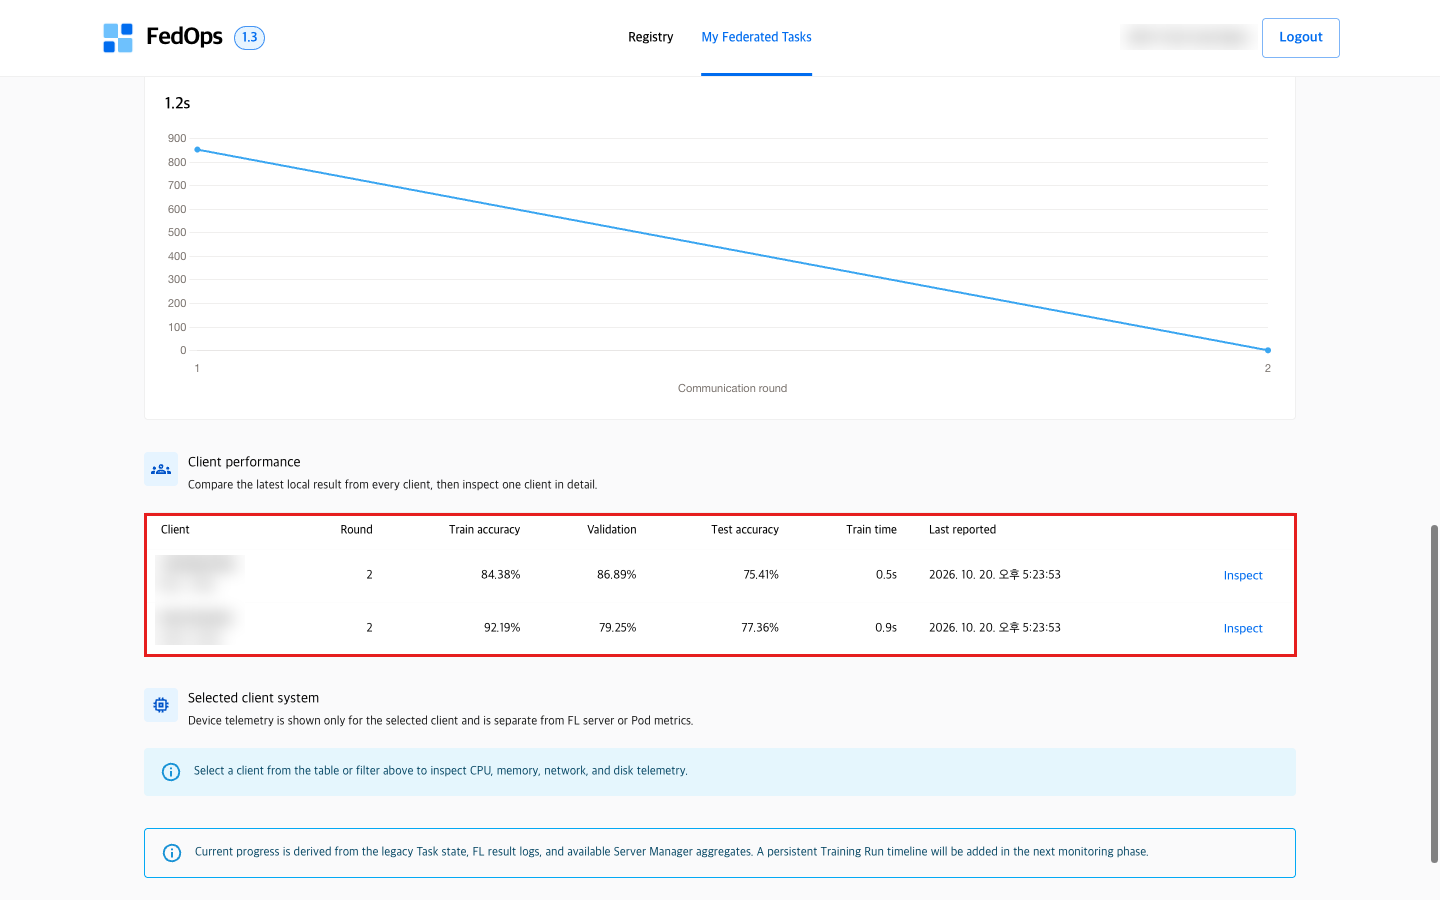
같은 화면 아래 Client performance 표에 참여자별 지표가 한 줄씩 나옵니다. Client 는 이름이 아니라 기기 ID 로 표시됩니다.
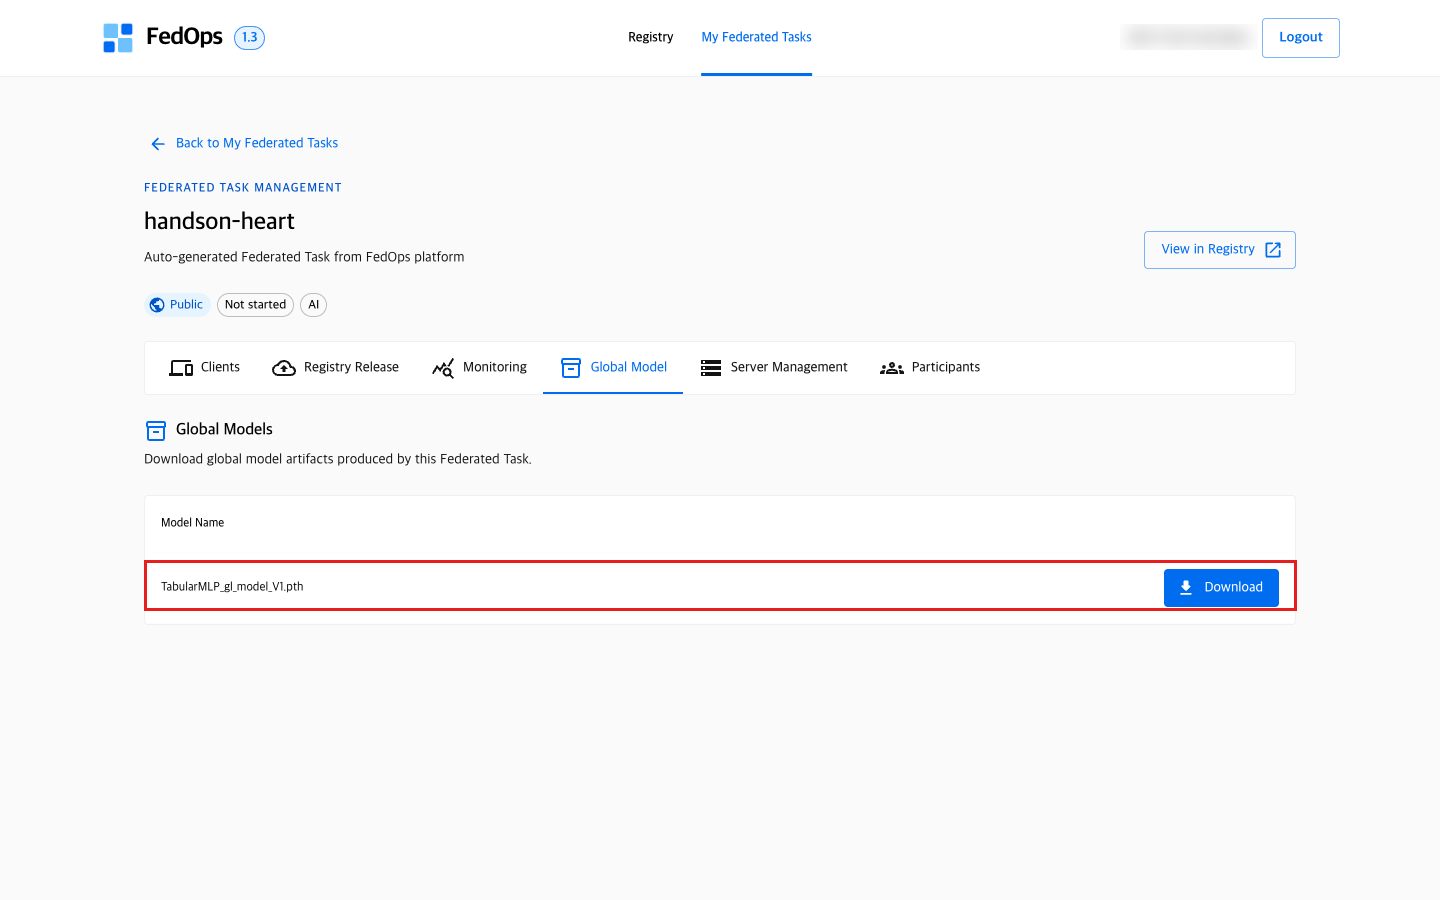
첫 캠페인이 끝나면 Global Model 탭에 TabularMLP_gl_model_V1.pth 가 생기고, 캠페인을 돌릴 때마다 V2, V3 … 이 더해집니다. 모델 활용 트랙의 Agent 가 이 모델을 씁니다.
⚙️ 해설 — Monitoring 에서 볼 수 있는 것
| 항목 | 읽는 법 |
|---|---|
| Campaign run · Communication round | 지금 몇 번째 판의 몇 라운드인지 |
| Clients completed / online | 이번 라운드를 끝낸 Client 수 / 연결된 Client 수. 라운드가 멈췄다면 여기부터 본다 |
| Global accuracy · Global loss | 라운드별 Global Model 성적 (6장 Global model evaluation 방식으로 계산) |
| Round duration | 라운드마다 걸린 시간. 가장 느린 Client 가 좌우한다 |
| Client 별 지표 | Client 를 고르면 그 Client 가 공개를 허용한 로컬 지표 |
2) 숫자 읽기
| 어디서 | 값 |
|---|---|
| Console Monitoring | Global accuracy 76.32%, Global loss 0.4559 (두 병원 test 114행 가중 평균) |
| Studio 연합학습 화면 (Owner) | Accuracy 77.36%, F1 No Disease 81.25%, F1 Disease 71.43% (헝가리 test 53행) |
| Console Global Model | TabularMLP_gl_model_V1.pth |
무엇을 확인하나. 이 튜토리얼에서 확인할 것은 숫자의 크기가 아니라 다음 세 가지입니다.
- 라운드가
2 / 2까지 진행됐다 — 서버가 두 병원의 학습을 기다려 합쳤다 - Client performance 에 두 줄이 있다 — 두 병원이 모두 학습에 참여했다
- Global Model 에 새 버전이 생겼다 — 데이터를 옮기지 않고 하나의 모델이 만들어졌다
(2026-10-20 두 계정 실측) 헝가리 입장에서 4장의 Initial Model(accuracy 0.7736, F1 Disease 68.42%)과 비교하면, accuracy 는 같고 F1 Disease 가 68.42% → 71.43% 로 올랐습니다. 클리블랜드 데이터가 더해져 심장병 환자를 조금 더 잘 잡게 됐습니다.
숫자는 어느 정도가 정상인가. 이 데이터는 원래 정확도 0.75~0.8 안팎이고, 두 병원이 함께 학습해도 오르는 폭이 작습니다. 같은 설정의 시뮬레이션(시드 20개 평균, 헝가리 test 기준)은 다음과 같았습니다.
| 비교 | 헝가리 test accuracy |
|---|---|
| Owner 혼자 첫 모델 (Initial Model) | 약 0.76 |
| Owner + Client 연합학습 2라운드 (Initial Model 에서 출발) | 약 0.78 |
| 모을 수 있다면 (두 병원 데이터 합쳐 학습) | 약 0.79 |
한 번의 실행에서는 좋아지지 않을 수도 있습니다. 위 시뮬레이션에서 연합학습이 Owner 혼자보다 나았던 경우는 20번 중 14번(70%)이고, 같았던 경우 1번, 나빴던 경우 5번이었습니다. 헝가리 test 가 90행 안팎이라 한두 명만 다르게 맞혀도 1~2%p 가 움직입니다. 숫자가 기대와 달라도 위 세 가지가 확인됐다면 연합학습은 제대로 돈 것입니다.
판단하는 법: Owner 와 Client 가 함께 만든 Global Model 이 Owner 혼자의 Initial Model 과 비슷하거나 조금 낫고, 1장의 “모을 수 있다면”에 가까우면 연합학습이 제 역할을 한 것입니다. 클리블랜드 병원의 데이터가, 병원 밖으로 나가지 않고도 모델에 반영되었다는 뜻이기 때문입니다.
3) 다음 캠페인과 정리
| 하고 싶은 것 | 방법 |
|---|---|
| 한 판 더 돌리기 | 캠페인을 다시 저장하고 Start FL server. 직전 Global Model vN 에서 출발해 vN+1 이 생긴다. 서버를 켤 때마다 양쪽 모두 참여 준비 점검을 다시 한다(6장) |
| 코드를 고치고 다시 | Owner 트랙 4장으로 돌아가 새 Release(revision 2)를 게시한 뒤 캠페인 |
| 실습 끝 | Server Management 의 Pause 로 서버 자원 반납 |
| 공개를 거두기 | Task actions → Delete task (되돌릴 수 없음) |
📚 연합학습 배경 — 지표를 볼 때 조심할 것
- Client metrics 는 Client 마다 잣대가 다르다. Validation OFF 에서는 각 Client 가 자기 test 데이터로 점수를 냅니다. 헝가리 병원은 심장병 없음이 62% 라 “다 없음”이라고만 해도 정확도가 0.62 입니다. 그래서 정확도만 보지 말고 F1 Disease 처럼 심장병 환자를 잡는 지표를 함께 봅니다.
- 혼자 돌린 연합학습은 연합의 효과가 아니다. Owner 혼자 2라운드를 돌려 좋아졌다면 같은 데이터로 더 학습한 효과입니다.
- Global Model 이 모든 병원에 좋다는 보장은 없다. 평균적으로는 좋아도 특정 병원에서는 그 병원 혼자 학습한 모델보다 나쁠 수 있습니다. 이 데이터에서도 VA 병원(심장병 78%)처럼 분포가 많이 다른 곳을 넣으면 Owner 기준 성능이 오히려 떨어지는 경우가 많았습니다. 이를 다루는 분야가 개인화 연합학습(personalized FL)입니다.
✅ 체크리스트
- live log 에서 라운드가 넘어가는 것을 봤다
- Console Monitoring 이
2 / 2라운드 완료다 - Client performance 에 두 병원 줄이 있다
- Global Model 탭에 새 버전(v1)이 생겼다
- 실습이 끝났으면 Pause 했다