
Blog
Federated Learning 환경에서의 Random Forest 최적화: FedRFBagging
Federated Learning 환경에서의 Random Forest 최적화: FedRFBagging 접근법
연합 학습의 중심은 주로 딥러닝 기반 모델에 집중되어 왔고, 트리 기반 모델, 특히 Random Forest에 대한 사용법은 제한적입니다.
FedOps는 이러한 한계를 해결하기 위해 FedRFBagging 알고리즘을 연구했으며, 이를 소개합니다. 이는 전통적인 Random Forest 모델의 장점인 Bagging 방식과 안정적인 예측 성능을 유지하면서 연합 학습 환경에 적합하게 최적화한 접근법입니다.
기존 Random Forest와 연합 학습 환경의 충돌
Random Forest는 각 트리를 독립적으로 학습하고 이를 앙상블하여 예측을 수행하는 방식입니다. 이러한 구조는 데이터 다양성에 강건하고 높은 예측 성능을 제공합니다. 그러나 연합 학습 상황에서는 다음과 같은 문제가 발생합니다.
- 통신 오버헤드 증가: 로컬에서 생성된 다수 트리를 서버로 전송해야 하므로 라운드 증가 시 비용 폭증
- 데이터 분포 차이: 클라이언트 간 데이터 분포 차이에 따라 트리 품질 불균형 발생
- 모델 일관성 문제: 단순 트리 집계 방식으로는 글로벌 모델 품질 저하 가능
기존 연구의 방법들은 부스팅(Boosting) 기반 접근법을 적용해 이러한 문제를 해결하려 했으나, 이는 Random Forest의 핵심 요소인 Bagging의 장점을 희석시키는 한계가 있습니다.
FedRFBagging: 핵심 아이디어
FedRFBagging 알고리즘은 Random Forest의 원리를 유지하면서 연합 학습에 적합하도록 다음과 같은 전략을 적용합니다.
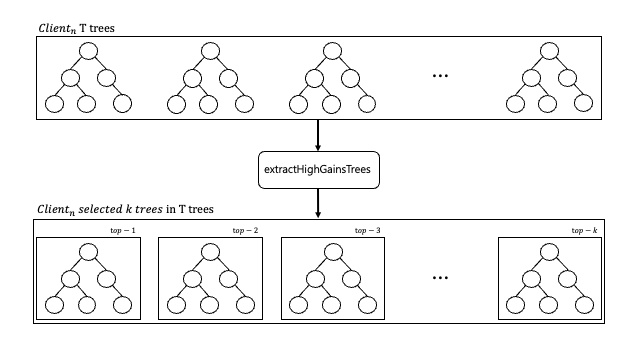
1. 각 클라이언트는 로컬 데이터로 Random Forest 학습
2. 성능이 가장 우수한 상위 k개의 트리만 서버로 전송
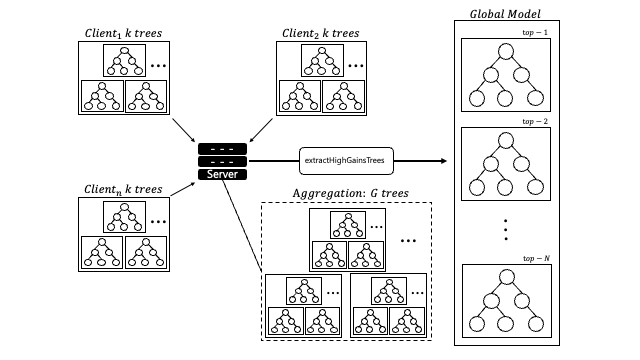
3. 서버는 모든 트리를 수집 후 불순도 기준으로 재선정
4. 글로벌 모델을 구성하여 클라이언트로 배포
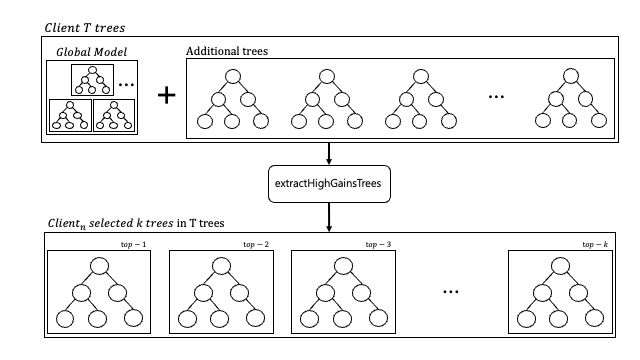
5. 클라이언트는 글로벌 모델을 기반으로 추가 트리 학습 및 로컬 최적화 수행
성능이 증명된 트리만 공유하는 선택적 전송 방식을 통해 통신 비용을 최소화하면서도 모델 품질을 유지합니다.
더 자세한 사항은 논문을 확인해 보시기 바랍니다: 연합 학습 환경에서의 랜덤 포레스트 알고리즘 최적화 전략 연구